Kubernetes Networking & CoreDNS: runbook tìm lỗi phân giải tên từ Pod
Pod ở trạng thái Running nhưng ứng dụng không gọi được api chưa đủ để kết luận CoreDNS hỏng. Có thể tên Service sai namespace, Service không có backend sẵn sàng, NetworkPolicy...
Biên soạn: Vibe DevOps · Đăng ngày
Bản đầy đủ · Poster fanpage
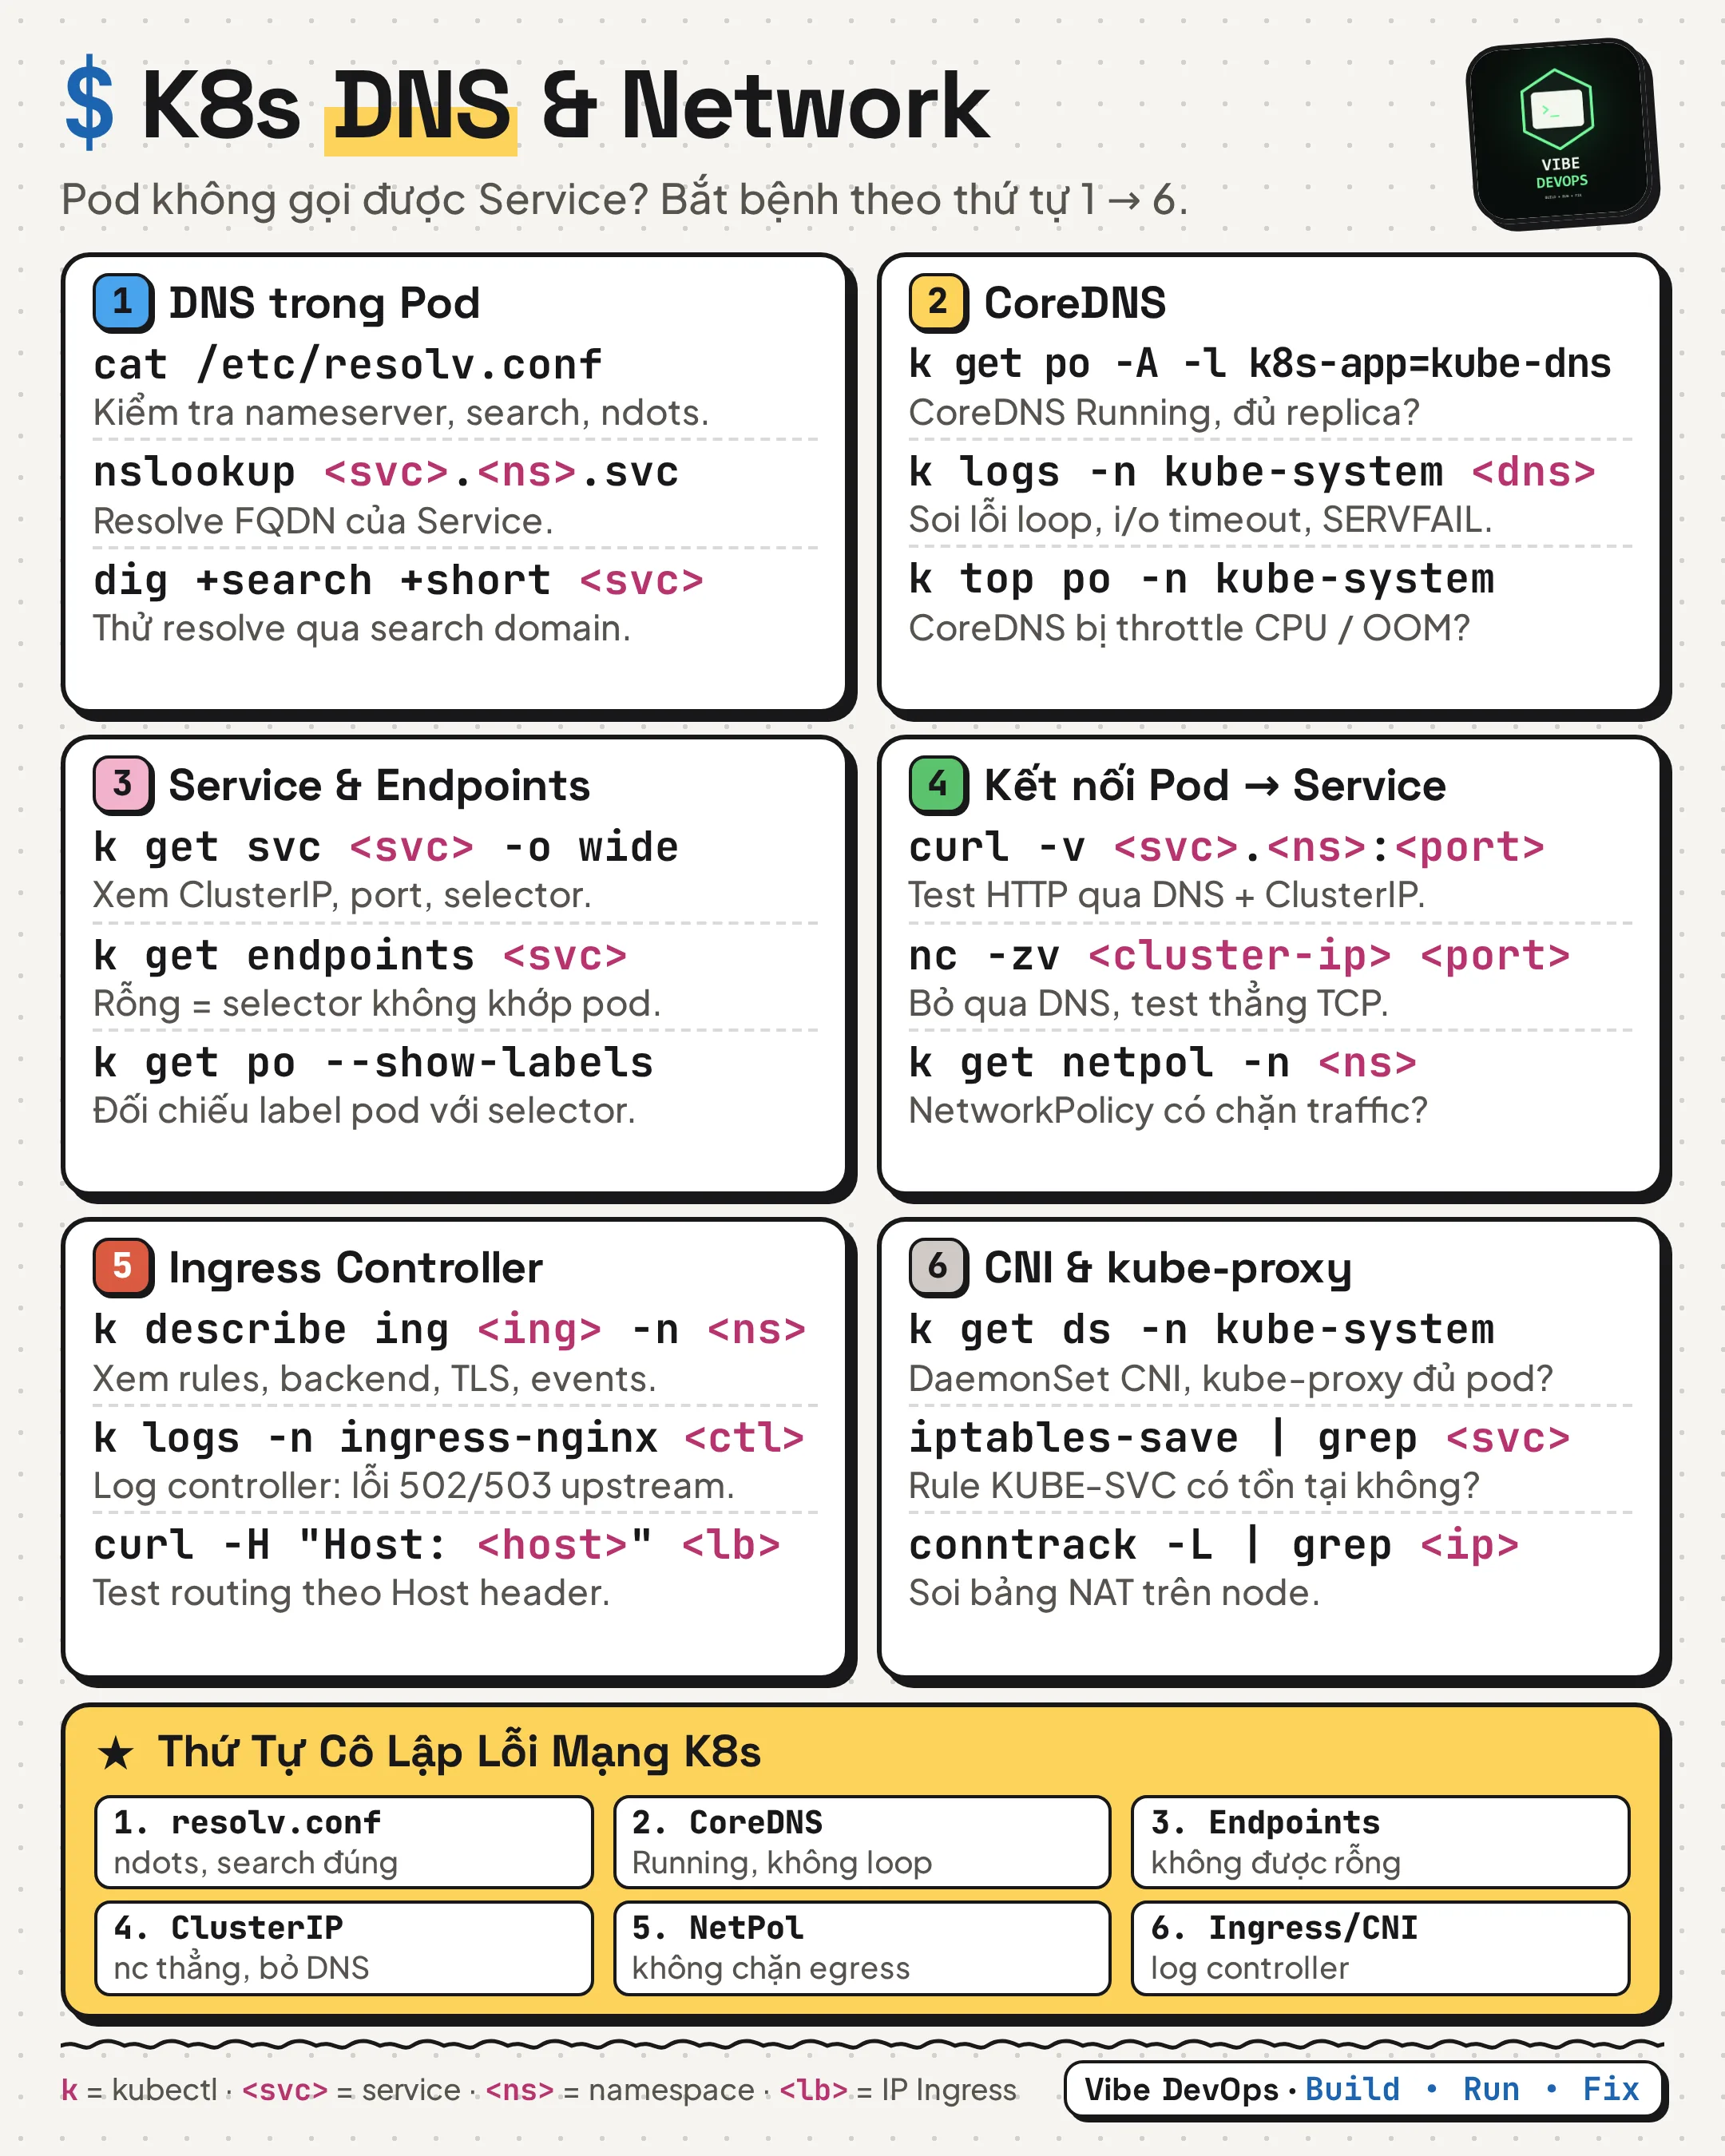

Pod ở trạng thái Running nhưng ứng dụng không gọi được api chưa đủ để kết luận CoreDNS hỏng. Có thể tên Service sai namespace, Service không có backend sẵn sàng, NetworkPolicy chặn DNS hoặc ứng dụng dùng sai cổng. Restart CoreDNS ngay từ đầu vừa làm rộng phạm vi ảnh hưởng vừa có thể mất bằng chứng. Runbook này đi từ client tới DNS, Service và backend để thu hẹp nguyên nhân bằng kết quả quan sát.
Phạm vi kiểm chứng: các lệnh dưới đây là hướng dẫn vận hành; chưa được thực thi trên cluster Kubernetes thật trong lượt biên soạn này. Tên tài nguyên là ví dụ, không phải kết quả của một incident đã xảy ra.
1. Chốt context, namespace và Pod gặp lỗi
Cần kubectl, kubeconfig đúng cluster và quyền đọc Pod, Service, EndpointSlice, NetworkPolicy. Đọc log và exec cần quyền riêng. Không yêu cầu cấp cluster-admin chỉ để làm theo bài này.
kubectl config current-context
NS=default
P=app-pod
kubectl -n "$NS" get pod "$P" -o wide
kubectl -n "$NS" describe pod "$P"
Thay default và app-pod bằng namespace và Pod thực tế. Ghi lại thời điểm lỗi, node, Pod IP, restart count, container gặp lỗi và một request cụ thể. Với Pod nhiều container, thêm -c TEN_CONTAINER cho exec và logs. Kiểm tra events nhưng đừng coi việc không có event là bằng chứng mạng hoạt động bình thường.
Ảnh dùng biến tắt k="kubectl -n $NS" trong shell tương tác; các ví dụ đầy đủ ở đây tránh phụ thuộc biến tắt đó. Không đặt tên tài nguyên lấy từ nguồn không tin cậy vào biến lệnh.
2. Xem resolver thật mà client đang dùng
kubectl -n "$NS" exec "$P" -- cat /etc/resolv.conf
kubectl -n "$NS" exec "$P" -- nslookup kubernetes.default
kubectl -n "$NS" exec "$P" -- nslookup api
kubectl -n "$NS" exec "$P" -- nslookup example.com
nameserver cho biết đích DNS, search cho biết hậu tố namespace và cluster, còn ndots ảnh hưởng thứ tự truy vấn. Không hardcode IP DNS từ cluster khác. Cluster có NodeLocal DNSCache có thể dùng địa chỉ local thay vì ClusterIP kube-dns.
Tên ngắn api thường được tìm trong namespace hiện tại. Nếu Service nằm ở namespace backend, thử api.backend, rồi FQDN theo domain cluster thật, ví dụ api.backend.svc.cluster.local. cluster.local là giá trị thường gặp, không phải quy tắc bắt buộc. Xem dnsPolicy, dnsConfig qua kubectl -n "$NS" get pod "$P" -o yaml; Pod hostNetwork cần cấu hình phù hợp, thường là ClusterFirstWithHostNet.
Nếu container thiếu cat hoặc nslookup, lỗi “executable not found” chỉ nói công cụ không tồn tại. Dùng Pod debug đã được tổ chức phê duyệt, trong đúng namespace và cân nhắc nhãn, service account, node, policy giống client. Một Pod debug không chịu cùng policy có thể cho kết quả tốt giả tạo. Tạo ephemeral container hoặc Pod mới là thao tác thay đổi cluster, cần tuân thủ quy trình riêng.
3. Đọc kết quả trước khi sửa
- NXDOMAIN: kiểm tra tên, namespace, hậu tố tìm kiếm và tài nguyên Service có tồn tại không. Đừng vội mở firewall.
- SERVFAIL: xem log CoreDNS, cấu hình plugin, quyền truy cập Kubernetes API và resolver upstream.
- Timeout: kiểm tra đường đi đến DNS, DNS Pod có sẵn sàng không, policy, CNI và NodeLocal DNSCache nếu có.
- Tên nội bộ được, tên bên ngoài lỗi: tập trung forwarder/upstream và egress thay vì sửa selector Service ứng dụng.
Kết quả này là hướng điều tra, không phải ánh xạ một-một tới nguyên nhân. DNS trả IP chỉ chứng minh truy vấn đó được trả lời; không xác nhận backend chạy, TLS đúng hay HTTP khỏe.
4. Đối chiếu Service với EndpointSlice
kubectl -n "$NS" get svc api -o wide
kubectl -n "$NS" describe svc api
kubectl -n "$NS" get endpointslice \
  -l kubernetes.io/service-name=api -o yaml
kubectl -n "$NS" get pods --show-labels
Đọc selector của Service rồi so với nhãn Pod. Với Service có selector, không có endpoint có thể do selector sai hoặc Pod chưa ready. Xem conditions.ready và port trong EndpointSlice; chỉ thấy địa chỉ chưa đủ. Service không selector hoặc ExternalName có cơ chế khác, không áp dụng máy móc kết luận “không endpoint là hỏng”. Headless Service cũng không có ClusterIP thông thường.
Nếu có công cụ HTTP trong client, thử cùng đường dẫn qua tên Service, ClusterIP và Pod IP với cổng tương ứng. Dùng timeout ngắn, ví dụ curl --connect-timeout 3 --max-time 5. Đừng gọi endpoint ghi dữ liệu để thử. Pod IP phải dùng cổng ứng dụng; Service IP phải dùng Service port. DNS tốt nhưng Service IP lỗi còn Pod IP được là hướng kiểm tra service dataplane, policy hoặc port mapping, không tự động chứng minh kube-proxy hỏng: một số CNI dùng eBPF thay kube-proxy.
5. Kiểm tra CoreDNS có giới hạn
kubectl -n kube-system get pods -l k8s-app=kube-dns -o wide
kubectl -n kube-system get svc kube-dns
kubectl -n kube-system logs -l k8s-app=kube-dns --tail=50
kubectl -n kube-system get configmap coredns -o yaml
Tên và label này là quy ước phổ biến; cluster được nhà cung cấp tùy biến có thể khác. Kiểm tra tất cả replica khi có nhiều Pod, không chỉ Pod đầu tiên. Tìm restart, readiness, timeout upstream, lỗi plugin hoặc plugin/loop. Loop thường liên quan vòng lặp forward tới resolver quay lại chính DNS, nhưng cần đối chiếu Corefile và resolver node trước khi sửa.
Không bật log toàn bộ truy vấn vô thời hạn trong production: log có thể chứa tên dịch vụ nội bộ và tạo tải lớn. Nếu cần, bật có thời hạn theo change procedure, ghi lại cấu hình trước thay đổi rồi khôi phục sau khi có bằng chứng.
6. NetworkPolicy, CNI và điểm dừng an toàn
kubectl -n "$NS" get networkpolicy
kubectl -n "$NS" describe networkpolicy
Kiểm tra egress từ client và ingress ở đích. DNS có thể dùng UDP lẫn TCP 53; chỉ cho UDP không giải quyết mọi trường hợp. Policy dựa trên namespaceSelector và podSelector cần khớp nhãn thực tế. Với NodeLocal DNSCache hoặc CNI riêng, xác nhận cách enforcement của sản phẩm trước khi viết rule.
Không xoá mọi policy, flush iptables hoặc restart toàn bộ node để thử. Khoanh vùng theo node và namespace, so sánh một client tốt với một client lỗi, rồi chuyển cho đội mạng bằng bằng chứng: mốc giờ, context, Pod/node/IP, tên truy vấn, phản hồi DNS và endpoint liên quan. Che thông tin nhạy cảm khi chia sẻ log.
Checklist kết thúc và nguồn tham khảo
Sau thay đổi đã được phê duyệt, chạy lại đúng truy vấn và request ban đầu từ client bị ảnh hưởng; kiểm tra thêm namespace/node khác, latency và lỗi ứng dụng. Theo dõi đủ lâu để tránh kết luận từ cache DNS, sau đó ghi nguyên nhân, thay đổi và cách rollback. Dọn Pod debug nếu đã tạo.
Tài liệu chính thức để đối chiếu theo phiên bản cluster:
Tải PDF vector ngay trên trang bài viết để có bảng tra sáu bước khi trực ca.
💡 Mẹo lưu trữ & sử dụng trong đội ngũ
Bạn có thể tải bản PDF vector về lưu trữ trong kho tài liệu nội bộ của team (Notion, Confluence) hoặc in khổ A4 dán tại bàn làm việc để tra cứu nhanh khi gặp sự cố lúc nửa đêm.